- Published on
YARN Capacity Scheduler와 Fair Scheduler 비교
- Authors

- Name
- 이동영
- Github
- @Github
YARN 스케줄러
YARN 스케줄러의 차이는 자원 할당 순서와 배분 기준에 있다. FIFO는 제출 순서에 따라 자원을 배분한다. Capacity Scheduler는 큐별 보장 용량을 기준으로 삼고 Fair Scheduler는 작업과 큐의 공정한 몫을 계산한다. Capacity Scheduler도 유휴 자원을 빌려 쓸 수 있고 Fair Scheduler도 최소 보장량을 설정할 수 있으므로 고정 분배와 동적 분배만으로 나누면 실제 동작을 오해하기 쉽다.
| 스케줄러 | 우선 보는 배분 기준 | 이 글에서 확인할 내용 |
|---|---|---|
| FIFO | 먼저 제출된 애플리케이션 | 공유 클러스터에서 긴 작업이 자원을 점유하는 문제 |
| Capacity | 큐별 보장 용량과 최대 용량 | 보장량을 넘겨 빌려 쓰는 경우와 Used Capacity 해석 |
| Fair | 큐와 작업의 수요와 공정한 몫 | Fair Share와 실제 할당량의 차이 |
"Spark 세션이 생성되지 않습니다. 확인해주세요."
Spark 기반 JupyterHub 환경을 운영하다 보면 심심치 않게 들어오는 문의다.
리소스 사용량이 어느 정도 예상되는 정기 데이터 파이프라인과 달리 대화형 개발 작업의 규모는 예측하기 어렵다. 한 사용자가 급한 업무로 여러 작업을 동시에 띄워 리소스를 독점하면 다른 작업자들은 세션을 생성하지 못하는 상황이 자주 발생한다.
이처럼 한정된 클러스터 리소스를 공유하는 환경에서 어떤 애플리케이션에 얼마만큼의 컨테이너 자원을 배분할지 결정하는 ResourceManager의 핵심 컴포넌트가 YARN Scheduler다.
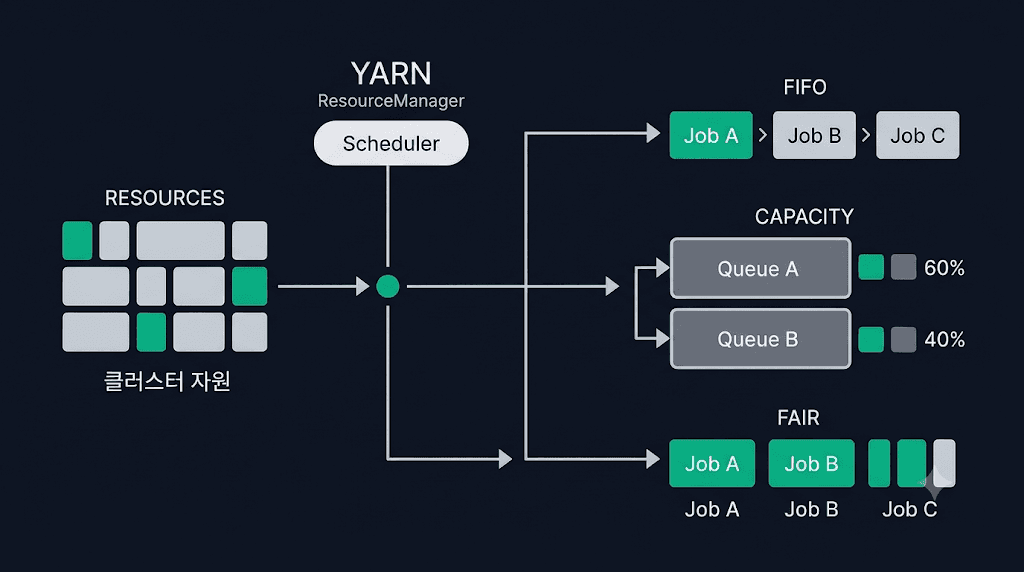
- FIFO Scheduler: 먼저 제출된 애플리케이션의 요청을 우선 처리(공유 환경에서는 뒤의 작업이 오래 대기할 수 있음)
- Capacity Scheduler: Hadoop 기본값으로 조직/팀 단위의 큐(Queue)별 리소스 용량 보장
- Fair Scheduler: 실행 중인 애플리케이션들에 수요와 가중치에 따라 공정한 자원 배분 기준을 계산
이번 글에서는 멀티테넌시 환경에서 실질적으로 사용되는 Capacity Scheduler와 Fair Scheduler 두 가지를 다룬다.
Capacity Scheduler
개념
Capacity Scheduler는 여러 조직이 하나의 대형 클러스터를 안전하게 공유(Multi-tenancy)할 수 있도록 리소스를 Queue(큐) 단위로 미리 분할해 보장하는 방식이다.
모든 큐는 최상위 큐인 root의 자식 큐로 구성되며(capacity-scheduler.xml) 각 큐에는 보장 용량과 최대 용량을 설정한다. 아래 예시에서는 capacity와 maximum-capacity를 퍼센트(%)로 지정한다. 퍼센트 방식으로 설정할 때 같은 계층에 있는 자식 큐들의 capacity 합은 반드시 100%가 되어야 한다.
root
├── queue-a (capacity: 40%, maximum-capacity: 60%)
└── queue-b (capacity: 60%, maximum-capacity: 100%)
위와 같이 설정하면 두 큐는 다음과 같이 동작한다.
- 탄력성(Elasticity):
queue-a는 최소 40%의 리소스를 보장받으며queue-b에 여유가 있을 때는 최대 60%(maximum-capacity)까지 확장해 쓸 수 있다. - 리소스 회수: 반대로
queue-b에 작업이 몰려 원래 용량(60%)이 필요해지면queue-a에서 실행 중인 컨테이너가 종료되는 대로 리소스를 돌려받거나 Preemption(선점) 설정을 통해 강제 회수한다.
YARN UI의 큐 전체 화면에서는 각 큐의 용량과 현재 사용량을 함께 확인할 수 있다.

YARN UI의 큐 용량 항목 읽기
큐 상세 화면에서는 설정한 용량과 현재 클러스터 크기로 환산한 용량 및 실제 사용량을 구분해서 읽어야 한다. memory의 단위는 MB이고 vCores는 YARN이 관리하는 가상 CPU 코어 수다. 여기서 사용량은 프로세스의 실제 메모리와 CPU 점유율이 아니라 컨테이너에 할당된 자원량을 뜻한다.
queue-a의 설정과 사용량 해석
다음은 클러스터의 스케줄링 대상 자원이 메모리 4096MB와 vCores 2개인 환경에서 root 하위의 queue-a(capacity: 40%와 maximum-capacity: 60%)를 조회한 화면이다. 이미지와 아래 표는 같은 큐의 값을 설명한다.
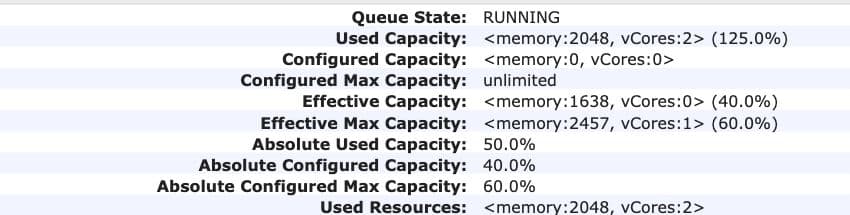
| 항목 | 화면의 값 | 의미 |
|---|---|---|
| Queue State | RUNNING | 새 애플리케이션을 제출받을 수 있는 큐 상태다. 작업이 현재 실행 중이라는 뜻은 아니며 제출 권한이나 다른 실행 제한은 별도로 적용된다. |
| Used Capacity | memory:2048, vCores:2 / 125.0% | 현재 큐에 할당된 자원량과 큐의 보장 용량 대비 사용률이다. 전체 메모리의 50%를 사용하므로 보장 비율 40% 대비 사용률은 125%다. |
| Configured Capacity | memory:0, vCores:0 | 메모리와 vCore 개수로 직접 설정한 보장 용량이다. 퍼센트 방식으로 설정한 경우 이 항목이 0으로 표시될 수 있으며 큐의 보장 비율이 0%라는 뜻은 아니다. |
| Configured Max Capacity | unlimited | 메모리와 vCore 개수로 직접 지정한 최대 용량 제한이 없다는 뜻이다. 클러스터 자원이나 퍼센트 방식의 최대 용량 제한까지 없어지는 것은 아니다. |
| Effective Capacity | memory:1638, vCores:0 / 40.0% | 설정한 보장 비율을 현재 자원량에 적용한 값이다. 메모리 40%에 해당하는 약 1638MB가 표시된다. 현재 사용량이나 전용으로 비워둔 자원량은 아니다. |
| Effective Max Capacity | memory:2457, vCores:1 / 60.0% | 현재 자원량에 최대 비율 60%를 적용해 계산한 값이다. 메모리 기준 최대 약 2457MB까지 확장하도록 설정되어 있으며 vCore 표시는 아래의 자원 계산 기준과 함께 읽어야 한다. |
| Absolute Used Capacity | 50.0% | 클러스터 전체 자원을 기준으로 이 큐가 현재 사용하는 비율이다. 메모리 4096MB 중 2048MB를 사용하므로 50%다. |
| Absolute Configured Capacity | 40.0% | 클러스터 전체를 기준으로 환산한 큐의 보장 비율이다. 이 큐는 root 바로 아래에 있으므로 설정한 40%와 같다. |
| Absolute Configured Max Capacity | 60.0% | 클러스터 전체를 기준으로 환산한 큐의 최대 사용 비율이다. 현재 메모리 사용 비율 50%는 이 한도 안에 있다. |
| Used Resources | memory:2048, vCores:2 | 현재 큐에 할당된 자원량이다. Used Capacity 앞부분에 표시된 자원량과 같다. |
Configured Capacity가 0인데 Effective Capacity가 1638MB인 것은 모순이 아니다. 이 예시는 자원량을 직접 지정한 대신 capacity=40으로 비율을 설정한 경우로 해석할 수 있다. 현재 자원량에 적용하면 보장 메모리는 4096 × 0.4 = 1638.4MB이고 최대 메모리는 4096 × 0.6 = 2457.6MB에 해당하며 화면에는 정수 자원량으로 표시된다.
또한 Effective Capacity의 vCores:0을 CPU 사용 금지로 읽어서는 안 된다. 기본 DefaultResourceCalculator는 메모리만으로 자원 비교와 용량 판단을 수행하므로 표시된 vCore 값과 실제 할당량을 단순 비교해서 큐 한도 위반이라고 판단할 수 없다. 이미지의 Used Resources에는 실제로 vCore 2개가 할당되어 있다. CPU까지 함께 고려하려면 yarn.scheduler.capacity.resource-calculator의 DominantResourceCalculator 설정 여부를 확인해야 한다.
Used Capacity와 Absolute Used Capacity의 차이
같은 화면에서 Used Capacity가 125%인데 Absolute Used Capacity는 50%인 이유는 계산 기준이 다르기 때문이다.
| 항목 | 계산 | 표시값 |
|---|---|---|
| Used Capacity | 현재 사용 비율 50% ÷ 보장 비율 40% × 100 | 125% |
| Absolute Used Capacity | 클러스터 전체 중 현재 사용 중인 비율 | 50% |
Used Capacity가 100%를 넘었다고 해서 클러스터 전체 용량을 초과한 것은 아니다. 큐에 보장된 몫보다 더 사용하고 있다는 뜻이다. queue-a는 다른 큐의 여유 자원을 빌려 사용 중이며 설정한 최대 용량 60% 안에 있다.
계층형 큐에서는 Effective Capacity 옆의 비율과 Absolute Configured Capacity도 달라질 수 있다. 부모 큐가 전체의 50%를 보장받고 자식 큐의 capacity가 60%라면 자식 큐의 클러스터 전체 기준 보장 비율은 50% × 60% = 30%다. 이름에 Absolute가 붙은 항목은 이처럼 클러스터 전체를 기준으로 환산한 값이다.
핵심 특징
| 특징 | 설명 |
|---|---|
| 용량 보장 (Capacity Guarantees) | 팀 혹은 서비스 큐의 보장 용량(capacity)을 설정함. 다른 큐가 빌려 쓴 자원은 컨테이너 종료나 선점으로 회수해야 함 |
| 계층적 큐 (Hierarchical Queues) | 큐 하위에 서브 큐를 두어 남는 리소스를 외부 큐보다 같은 조직 내 형제 서브 큐에 우선 공유 가능 |
| 단일 유저 독점 방지 (Multi-tenancy) | 큐 내부에서도 특정 사용자가 리소스를 독점하지 못하도록 유저별 제한(minimum-user-limit-percent와 user-limit-factor) 조정 가능 |
| Preemption (선점) | 선점이 활성화되고 조건이 충족되면 보장 용량이 부족한 큐를 위해 초과 사용 중인 다른 큐의 컨테이너를 회수 |
| 큐 내부 스케줄링 정책 | 큐 내부의 애플리케이션 실행 순서로 fifo(기본값이며 우선순위 지원) 또는 fair(FairOrderingPolicy) 선택 가능 |
언제 쓰나
- 팀/서비스별로 SLA가 명확히 다를 때 (예: A팀 배치 큐의 보장 용량을 40%로 설정)
- 정해진 시간 내에 작업 완료가 중요한 정기 배치 파이프라인 환경
- 워크로드 우선순위와 리소스 예산이 명확히 분리된 멀티테넌트 클러스터
Fair Scheduler
개념
Fair Scheduler는 큐와 애플리케이션의 수요 및 가중치에 따라 공정한 자원 배분 기준(Fair Share)을 계산하는 방식이다. 같은 큐 안에서 동일한 가중치의 애플리케이션들이 경쟁한다고 가정하면 두 개일 때는 각 50%가 배분 기준이 되고 세 개일 때는 약 33.3%씩이 된다. 이 예시는 충분한 수요가 있고 다른 제한이 없는 경우다. 실제 자원은 기존 컨테이너가 종료되거나 선점되어 여유가 생겨야 할당할 수 있다.
Capacity Scheduler처럼 계층적 큐(fair-scheduler.xml)를 지원하며 특히 별도의 큐 배치 규칙을 설정하지 않으면 기본적으로 작업을 제출한 사용자 이름(username)으로 큐를 자동 생성(yarn.scheduler.fair.user-as-default-queue=true)해 사용자 간 리소스를 공평하게 나눈다.
YARN UI의 큐 전체 화면에서는 각 큐의 실제 사용량과 Fair Share를 비교할 수 있다.

YARN UI의 Fair Scheduler 항목 읽기
Fair Scheduler의 큐 상세 화면에서는 **현재 할당량과 요청한 총수요 및 공정 배분 기준(Fair Share)**을 구분해서 읽어야 한다. memory는 MB이고 vCores는 YARN의 가상 CPU 자원 수이며 사용량은 실제 프로세스 사용률이 아니라 컨테이너에 할당한 자원량이다.
queue-b의 설정과 사용량 해석
다음은 root 하위의 queue-b 상세 화면이다. 현재 사용량과 두 Fair Share의 메모리 값은 모두 2048MB이며 활성 애플리케이션은 하나다. 이미지와 아래 표는 같은 큐의 값을 설명한다.
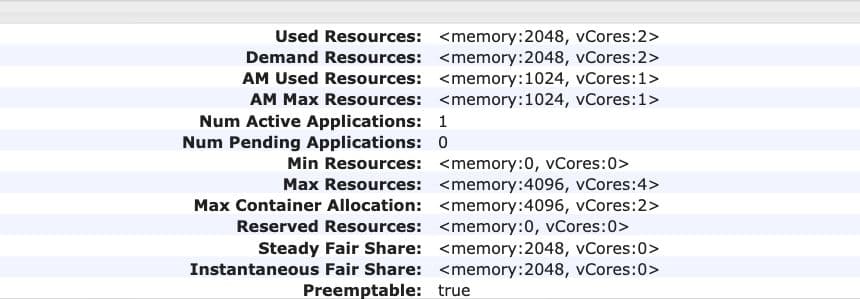
| 항목 | 화면의 값 | 의미 |
|---|---|---|
| Used Resources | memory:2048, vCores:2 | 큐의 컨테이너에 현재 할당된 전체 자원량이다. AM에 할당한 자원도 포함된다. |
| Demand Resources | memory:2048, vCores:2 | 현재 할당량과 아직 할당받지 못한 요청량을 합산한 큐의 총 수요다. 큐의 최대 자원량을 상한으로 집계된다. 미할당 요청량만을 뜻하지 않는다. |
| AM Used Resources | memory:1024, vCores:1 | 이 큐의 ApplicationMaster 컨테이너들에 현재 할당된 자원량이다. Used Resources와 별도로 더하면 중복 계산된다. |
| AM Max Resources | memory:1024, vCores:1 | 이 큐에서 AM 용도로 사용할 수 있는 자원의 현재 한도다. maxAMShare와 큐의 Fair Share 등을 반영해 계산하며 큐 전체의 사용 한도와는 다르다. |
| Num Active Applications | 1 | 컨테이너를 할당받아 활성 상태로 집계되는 애플리케이션 수다. 이 애플리케이션의 모든 Executor가 확보되었다는 뜻은 아니다. |
| Num Pending Applications | 0 | 아직 컨테이너를 받지 못했거나 동시 실행 제한 등으로 대기하는 애플리케이션 수다. 이 값이 0이어도 활성 애플리케이션의 추가 컨테이너 요청은 대기할 수 있다. |
| Min Resources | memory:0, vCores:0 | 큐에 명시적으로 설정한 최소 보장 자원량이다. 0이어도 Fair Share에 따라 자원을 배정받을 수 있다. |
| Max Resources | memory:4096, vCores:4 | 큐 전체에 설정된 자원 사용 상한이다. 이만큼의 자원이 클러스터에 실제로 존재하거나 즉시 할당된다는 뜻은 아니다. |
| Max Container Allocation | memory:4096, vCores:2 | 컨테이너 하나가 요청할 수 있는 자원의 상한이다. Max Resources가 큐 전체 한도인 것과 구분해야 한다. |
| Reserved Resources | memory:0, vCores:0 | 요청한 컨테이너를 이후에 할당하기 위해 노드에 예약해 둔 자원량이다. 현재 예약은 없으며 Min Resources처럼 큐에 보장한 몫을 뜻하지 않는다. |
| Steady Fair Share | memory:2048, vCores:0 | 비활성 큐까지 포함해 계산한 안정적인 공정 배분 기준이다. 설정과 클러스터 용량을 기준으로 예상 몫을 보여주며 과거 사용량의 평균은 아니다. |
| Instantaneous Fair Share | memory:2048, vCores:0 | 현재 활성 큐들을 대상으로 계산한 공정 배분 기준이다. 실제 스케줄링 판단에 사용하며 다른 큐가 사용하지 않는 자원이 있으면 이 몫을 넘어 사용할 수도 있다. |
| Preemptable | true | 필요한 조건이 충족되면 다른 큐를 위해 이 큐의 자원을 선점해 회수할 수 있다는 뜻이다. 이 큐가 다른 큐의 자원을 선점할 권한을 나타내는 값은 아니다. |
Fair Share의 vCores가 0으로 표시되는 이유
위 화면에서 Used Resources의 vCores는 2인데 Steady Fair Share와 Instantaneous Fair Share의 vCores는 모두 0이다. Fair Scheduler의 기본 정책인 fair(FairSharePolicy)는 메모리만을 기준으로 공정 배분치를 계산하므로 이런 표시가 나타날 수 있다. CPU를 쓸 수 없거나 CPU 한도가 0이라는 뜻은 아니다. 메모리와 CPU를 함께 고려하려면 drf(Dominant Resource Fairness) 정책을 사용한다. 이때 부모 큐의 정책과도 호환되도록 설정해야 한다.
두 Fair Share 지표의 차이는 비활성 큐를 계산에 포함하는지에 있다. 메모리 4096MB를 동일한 가중치의 두 큐(queue-a와 queue-b)에 나누고 별도의 용량 제약이 없다면 두 큐가 모두 활성 상태일 때 각각의 Steady Fair Share와 Instantaneous Fair Share는 2048MB로 계산된다.
이후 queue-a가 비활성화되고 다른 활성 큐나 상한 제약이 없다면 queue-b의 Steady Fair Share는 2048MB로 남고 Instantaneous Fair Share는 4096MB로 늘어날 수 있다. Fair Share는 배분 기준이며 실제 할당량은 아니다. 이 화면처럼 총수요가 2048MB라면 배분 기준이 커졌다는 이유만으로 추가 컨테이너가 자동으로 할당되지는 않는다. 실제 확보한 자원은 Used Resources에서 확인한다.
이 화면에서 읽을 수 있는 클러스터 상태
현재 queue-b에는 활성 애플리케이션이 하나 있고 총 memory:2048, vCores:2가 할당되어 있다. 이 중 ApplicationMaster(AM Used Resources)가 memory:1024, vCores:1을 차지하므로 나머지 컨테이너에 할당된 자원은 memory:1024, vCores:1이다. 해당 애플리케이션이 Spark라면 나머지가 Executor 컨테이너인지 애플리케이션의 컨테이너 목록에서 확인할 수 있다.
총수요(Demand Resources)도 현재 할당량과 같은 memory:2048, vCores:2다. 이 화면에서 집계된 범위에서는 미할당 추가 수요가 없는 것으로 해석할 수 있다. 다만 이는 조회 시점의 값이며 Demand Resources는 큐의 최대 자원량을 상한으로 집계되므로 일반적으로 두 값이 같다는 이유만으로 모든 대기 요청이 없다고 단정해서는 안 된다.
주목할 점은 AM 사용량이 현재 표시된 AM 한도(memory:1024, vCores:1)에 도달했다는 것이다. maxAMShare 제한이 적용되고 현재 한도가 유지되는 동안에는 새 애플리케이션의 AM에 필요한 여유가 없어 YARN의 ACCEPTED 상태로 대기할 수 있다. AM 한도 자체도 Fair Share 등에 따라 다시 계산되므로 이 화면만으로 이후 제출할 애플리케이션이 반드시 대기한다고 단정할 수는 없다.
AM 한도가 찼다는 이유만으로 기존 애플리케이션의 추가 Executor 할당까지 막히는 것은 아니다. Executor 할당은 큐 전체 한도(Max Resources)와 컨테이너별 한도 및 클러스터의 가용 자원과 배치 조건 등을 별도로 만족해야 한다.
마지막으로 Preemptable:true는 이 큐가 선점 제외 대상(allowPreemptionFrom=false)이 아니라는 뜻이며 현재 선점이 일어나고 있다는 뜻은 아니다. 실제 선점에는 전역 설정(yarn.scheduler.fair.preemption=true)과 클러스터 사용률 기준이 적용된다. 또한 자원이 부족한 큐에서 최소 보장량 또는 Fair Share 부족에 대한 대기 시간과 임계값 조건이 충족되어야 한다. 예를 들어 Fair Share 부족에 따른 선점에는 fairSharePreemptionTimeout과 fairSharePreemptionThreshold가 관여한다.
핵심 특징
| 특징 | 설명 |
|---|---|
| 동적 공정 분배 (Fair Sharing) | 기본 500ms(yarn.scheduler.fair.update-interval-ms) 주기로 Fair Share와 수요를 재계산한다. 실제 자원 할당은 가용 컨테이너와 스케줄링 조건에 따라 진행된다. |
| 응답성 및 기아 완화 | 자원을 적게 확보한 큐나 애플리케이션에 할당 기회를 주어 작은 잡의 대기를 줄이는 데 도움이 된다. 이미 자원을 점유한 컨테이너가 있으면 종료나 선점으로 자원이 확보되어야 한다. |
| 유연한 스케줄링 정책 | 기본 fair는 메모리 기준으로 공정성을 계산한다. 메모리와 CPU를 함께 고려하는 drf 또는 순서 기반 fifo도 지원하며 부모와 자식 큐의 정책 호환성 제약을 따라야 한다. |
| 최소 보장량 및 가중치 | 큐별 최소 보장 자원(minResources)과 가중치(weight)를 설정할 수 있다. 예를 들어 가중치 2:1로 배분 기준을 조정할 수 있으며 실제 할당량은 수요와 한도 등에 따라 달라진다. |
| 자동 설정 리로드 | 기본 할당 설정 파일인 fair-scheduler.xml의 변경을 감지해 런타임에 반영한다. 공식 문서는 파일 변경을 확인한 뒤 약 10~15초 후 다시 읽는다고 설명한다. 이 동작은 할당 설정 파일에 해당하며 yarn-site.xml의 모든 설정까지 자동으로 반영하는 것은 아니다. |
언제 쓰나
- 작업의 크기와 실행 시점이 예측 불가능한 대화형 개발 환경(JupyterHub와 Ad-hoc 쿼리)
- 무거운 장기 실행 잡과 가벼운 단기 잡이 섞여 있어 작은 잡의 대기 시간을 줄여야 할 때
- 고정 용량 비율보다 사용자별 수요와 가중치를 중심으로 자원을 배분하고 싶을 때
비교 요약
| 항목 | Capacity Scheduler | Fair Scheduler |
|---|---|---|
| 핵심 철학 | 조직/팀 단위의 용량 보장과 사용 한도 관리 | 애플리케이션/유저 간의 공정한 동적 분배 |
| 기본 큐 동작 | root.default 단일 큐에 제출 (명시적 큐 설계 필요) | 기본 설정에서 제출자 이름으로 큐 생성 가능 (큐 배치 규칙에 따라 달라짐) |
| 리소스 보장 방식 | 큐별 비율(%) 또는 절대량(capacity) 보장 | 수요와 가중치에 따른 Fair Share 계산 (minResources로 최소 보장 가능) |
| 리소스 계산 기준 | 메모리 중심 (설정에 따라 CPU/GPU 확장) | 기본 fair는 메모리 기준이며 drf 설정 시 메모리와 CPU를 함께 고려 |
| 리소스 탄력성 | 여유 리소스를 maximum-capacity 한도까지 대여 | 수요와 한도에 따라 여유 자원을 활성 큐와 애플리케이션에 할당 |
| 런타임 설정 반영 | capacity-scheduler.xml 수정 후 rmadmin -refreshQueues 실행 | fair-scheduler.xml 변경 확인 후 약 10~15초 내 자동 반영 |
| 적합한 워크로드 | 팀별 SLA가 중요한 엔터프라이즈 배치 파이프라인 | JupyterHub와 대화형 분석 및 크기가 다양한 혼합 워크로드 |
| AWS EMR 기본값 | 기본 제공 (CapacityScheduler) | 별도 설정 필요 (yarn-site Classification 변경) |
마무리
스케줄러를 선택할 때는 누구에게 어떤 기준으로 자원을 나눌지부터 정해야 한다. 팀별로 보장할 용량과 최대 사용 범위를 명확히 관리하려면 Capacity Scheduler가 적합하다. 작업의 크기와 실행 시점이 유동적인 환경에서 공정 배분을 중심으로 운영하려면 Fair Scheduler를 검토할 수 있다.
Capacity Scheduler도 다른 큐의 여유 자원을 빌려 쓸 수 있고 Fair Scheduler도 최소 보장량과 가중치를 설정할 수 있다. 두 방식 모두 워크로드와 큐 정책에 맞춰 조정해야 하므로 어느 하나가 항상 더 공평하거나 자원을 더 잘 활용한다고 단정하기는 어렵다.
운영 화면에서는 실제 사용량과 배분 기준을 구분하는 것이 중요하다. Capacity Scheduler에서는 큐의 보장량 대비 사용률과 클러스터 전체 대비 사용률을 나눠 읽어야 한다. Fair Scheduler에서는 현재 할당량과 총수요 그리고 Fair Share를 함께 확인해야 한다. 그래야 큐가 보장량을 넘겨 자원을 빌려 쓰는지 또는 추가 할당을 기다리는지 판단할 수 있다.
설정 조정과 장애 진단은 후속 글인 EMR YARN 큐 설정과 Spark ACCEPTED 대기 진단에서 이어서 다룬다. AM 한도와 사용자별 자원 제한 및 선점 설정을 중심으로 살펴본다.