- Published on
구글 검색엔진의 동작과 검색엔진 최적화(SEO)
- Authors

- Name
- 이동영
- Github
- @Github
웹사이트는 주로 구글 혹은 네이버 검색을 통해 노출되기 때문에 구글 또는 네이버 검색을 했을 때 내가 만든 웹 사이트가 잘 나와야지만 사용자들이 방문할 확률이 올라간다.
검색엔진 최적화란 구글 혹은 네이버와 같은 검색엔진이 나의 웹사이트를 잘 이해하도록 함으로써 검색 결과의 상단에 노출되게 하기 위한 작업이다.
세계적으로 많이 사용하는 검색엔진이 구글인 만큼 구글 문서를 참고하여 구글 검색엔진의 원리에 초점을 맞춰 조사했다.
구글 검색의 3단계
구글 검색 센터 에 따르면 Google의 검색은 세 단계로 작동하며, 각 단계가 모든 웹 페이지에 적용되지는 않는다고 한다.
이 세가지 단계는 다음과 같다.
- 크롤링(Crawling) : 구글이 URL을 발견하고 인터넷을 탐색하는 단계
- 색인생성(Indexing) : 구글이 페이지가 어떤 내용을 가지고 있고, 인터넷의 다른 페이지와의 관계를 파악하고 해당 정보를 검색 가능한 형식으로 저장하는 단계
- 검색결과 게재(Serving) : 구글이 검색 결과에 순위를 부여하고 게재하는 단계
이와 같은 검색의 원리에 따라 본인의 웹 사이트가 상위 결과에 나올 수 있도록 하는 작업을 진행해 검색엔진 최적화를 수행할 수 있다.
1. 크롤링(Crawling)
구글은 크롤러라는 자동화된 프로그램을 통해 새로운 웹 페이지나 업데이트된 웹 페이지를 찾는다.
URL discovery(URL 검색)
새로운 페이지는 대게 Google 이 이미 크롤링한 전적이 있어 파악된 웹 페이지에서 새로운 페이지로 연결되는 링크를 따라갈 때 발견된다. 이렇게 새로운 페이지와 업데이트된 페이지가 검색되면 파악된 페이지 목록에 추가된다. 이런 과정을 URL dicovery 하고 한다.
Googlebot
Googlebot 은 구글의 메인 크롤러로 웹 페이지를 가져오는 역할을 한다. Googlebot 은 알고리즘 프로세스를 사용하여 크롤링의 빈도와 가져올 페이지 수와 같은 값들을 결정하고, 대상이 대는 사이트에 과부하를 주지 않기 위해 빠른 크롤링을 수행하지 않는다.
Googlebot 은 브라우저가 웹페이지를 렌더링하는 방식과 유사하게 자바스크립트를 실행한다. 이는 웹사이트가 클라이언트 사이드 렌더링 기술을 사용할 경우 자바스크립트들 사용해 페이지에 콘텐츠를 표시하기 때문에 렌더링하는 과정이 필요하다.
robots.txt
robots.txt 는 크롤러가 사이트에서 액세스 할 수 있는 URL을 검색엔진 크롤러에게 알려주기 위해 작성되는 파일로, 주로 요청으로 인해 사이트가 오버로드 되는 것을 방지하기 위해 사용된다. 다만 robots.txt는 크롤러의 동작을 제어하지는 못하기에 지침을 준수하는 크롤러가 아닐 경우 효과가 없을 수 있다. robots.txt 에 대한 goole의 문서를 확인하면 자세한 내용이 있다.
sitemaps
사이트맵(sitemaps)은 사이트 페이지의 URL을 모아둔 곳으로 검색엔진은 이 파일을 읽어 더 효율적으로 크롤링 하기에 사이트맵의 작성은 google 에 사이트를 노출시킬 때 큰 도움이 된다. sitemaps 에 대한 google의 문서 에 역시 자세한 내용이 있다.
2. 색인생성(Indexing)
페이지가 크롤링되고 렌더링되면 다음 단계는 페이지에 있는 내용을 정확히 파악한 후 색인을 생성 할지 하지 않을지 결정할 때 도움을 주는 요소들을 확인하는 것이다. 이 때 HTML 태그들과 텍스트 콘텐츠 및 핵심 콘텐츠 태그와 속성을 처리하고 분석한다. 또한 이 과정에서 인터넷에 있는 다른 페이지들과의 중복되는지 아니면 표준(canonical) 페이지인지 판단한다. 표준 페이지를 정하기 위해 Google은 먼저 인터넷에서 찾은 비슷한 콘텐트의 페이지를 그룹으로 묶는데 이를 클러스터링이라고 한다. 표준 페이지는 이 클러스터에서 하나로 선택이 된다.
표준 페이지와 클러스터의 정보는 구글이 대규모 데이터베이스에 저장이 된다.이를 Google 색인이라고 한다. 다만 페이지의 콘텐츠 품질이 낮거나 Robots meta 규칙이 색인의 생성을 허용하지 않거나 웹사이트 자체가 색인 생성이 어렵도록 구성되어 있다면 색인 생성이 되지 않을 수 있다. SEO 를 위해서는 이런 색인 생성이 쉬운 구조의 웹사이트를 작성하는 것이 중요하다.
3. 검색결과 게재(Serving)
구글에 검색어를 입력하면 컴퓨터가 색인에서 검색어와 일치하는 페이지를 찾고 그 중에서 품질과 신뢰성 그리고 검색어와의 연관성이 가장 높다고 판단한 결과를 화면에 표시한다. 검색 결과 추출은 검색어를 해석하는 것으로 시작된다.
Google은 검색어와 관련된 페이지를 색인에서 찾고 여러 신호로 순위를 정한다. 내부 처리 순서를 이 글에서 검증한 것은 아니므로 불용어 제거 같은 특정 파이프라인을 보편적인 규칙으로 단정하지 않는다.
순위는 대개 검색 결과와 사용자의 관련성에 따라 달라진다. 이런 관련성을 결정하는 요소는 수백가지이며 그 중에서 가장 중요한 것은 페이지가 가지고 있는 컨텐츠이고 사용자의 위치, 언어, 디바이스의 유형등도 중요하다.
여기서 페이지 콘텐츠의 품질이란 다양한 요소로 평가되는데 여기는 콘텐츠의 독창성 것들이 포함되는데, 검색엔진 최적화를 위해 지킬 수 있는 핵심사항은 Google 검색 Essentials에 나와있다.
Next.js·Vercel 블로그에 직접 적용하기
2026년 11월 2일, 이 블로그의 SEO 설정을 점검했다. 블로그는 Next.js App Router와 MDX를 사용하고 Vercel에 배포한다. 도메인은 Cloudflare에서 관리하며, 실제 운영 주소는 https://blog.movingzero.org다.
코드를 확인해 보니 SEO 기능이 없는 상태는 아니었다. app/sitemap.ts와 app/robots.ts가 있었고, 글마다 제목과 요약, Open Graph 메타데이터, BlogPosting JSON-LD도 생성하고 있었다. 문제는 설정에 남아 있던 예전 주소와 일부 누락된 값이었다.
1. 실제 운영 도메인으로 URL 통일하기
기존 siteUrl은 아래처럼 Vercel 기본 주소였고, 끝에 /가 붙어 있었다.
siteUrl: 'https://dong5854-blog-lac-one.vercel.app/'
사이트맵과 구조화 데이터에서는 ${siteUrl}/${post.path}로 경로를 붙였다. 결과적으로 실제 도메인과 다른 주소가 생성됐고, 호스트 뒤에 //도 들어갔다. 운영 중이던 robots.txt도 예전 Vercel 주소의 사이트맵을 안내하고 있었다.
대표 주소를 아래처럼 바꾸고, Velite 설정에 따로 적혀 있던 주소도 같은 설정을 참조하도록 수정했다.
// data/siteMetadata.ts
siteUrl: 'https://blog.movingzero.org'
// velite.config.ts
import siteMetadata from './data/siteMetadata'

const { siteUrl, socialBanner } = siteMetadata
루트 레이아웃의 metadataBase도 이 값을 사용하므로 canonical과 공유용 URL의 기준이 함께 바뀐다. 이미지 주소는 문자열을 이어 붙이는 대신 new URL(image, siteUrl).href로 생성했다. 구조화 데이터의 이미지도 절대 URL로 만들고, 이미지가 없을 때는 기본 배너를 사용하도록 했다.
canonical은 중복 URL 가운데 대표 주소를 검색엔진에 알려주는 신호다. Google이 반드시 그 주소를 선택한다는 뜻은 아니므로, 내부 링크와 사이트맵, 리디렉션도 같은 주소를 가리키도록 맞췄다.
2. 기존 Vercel 주소를 영구 리디렉션하기
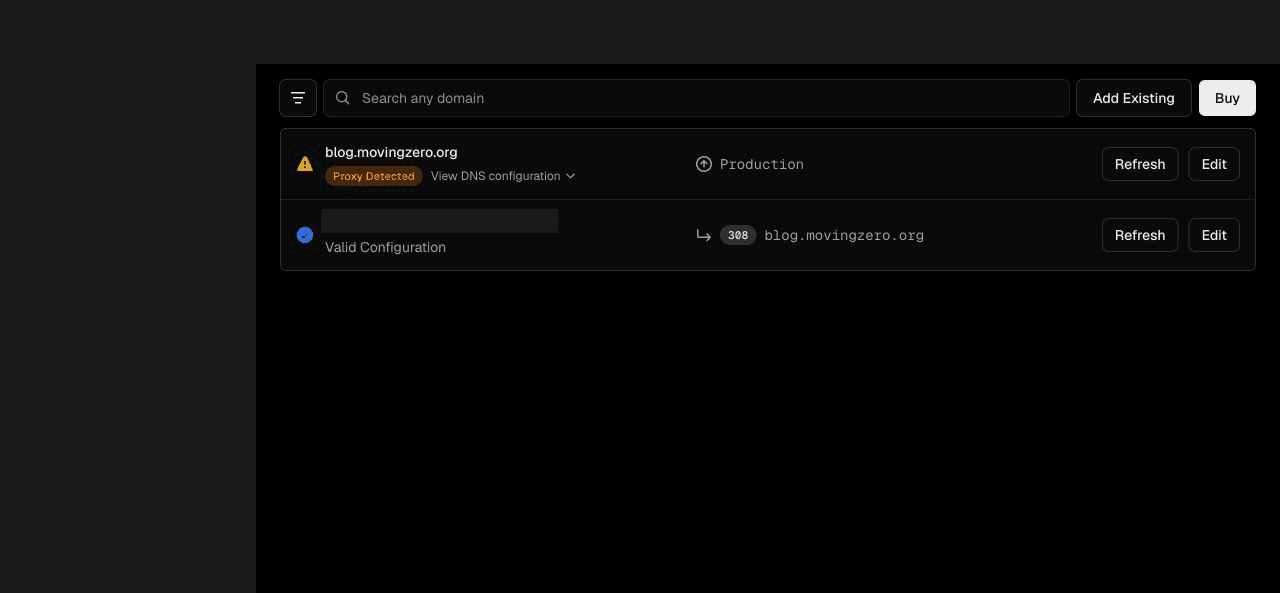
도메인을 연결한 뒤에도 예전 vercel.app 주소에서 같은 글이 열리고 있었다. Vercel 프로젝트의 기존 도메인에 blog.movingzero.org를 대상으로 하는 308 영구 리디렉션을 설정했다.
검증할 때는 홈뿐 아니라 글 경로와 쿼리 문자열도 확인했다.
https://dong5854-blog-lac-one.vercel.app/blog/spark/spark-architecture?test=1
    ↓ 308
https://blog.movingzero.org/blog/spark/spark-architecture?test=1
이 설정은 Vercel의 도메인 설정에 저장된다. 소스 코드를 복제하는 것만으로 리디렉션까지 복제되지는 않는다. Cloudflare의 DNS를 바꾸지 않고 기존 Vercel 주소에서 들어오는 요청을 대표 주소로 보내도록 처리했다.
3. 일반 메타 설명 누락 보완하기
공통 메타데이터 함수는 전달받은 description을 Open Graph에만 넣고 있었다. 일반 <meta name="description">에도 페이지별 설명이 반영되도록 수정했다. Twitter 카드에도 같은 설명을 넣었다.
return {
  title,
  description: description || siteMetadata.description,
  // Open Graph와 Twitter 카드에도 설명을 설정한다.
}
블로그 전체 설명은 dong5854's 블로그에서 실제 글의 주제를 알 수 있는 문장으로 바꿨다.
Spark·AWS EMR·백엔드 개발 경험과 문제 해결 과정을 기록하는 기술 블로그입니다.
개별 글은 기존처럼 MDX의 summary를 설명으로 사용한다. 메타 설명을 넣었다고 검색 결과에 그대로 표시되는 것은 아니다. Google은 검색어와 본문에 따라 다른 문구를 선택할 수 있다.
4. 사이트맵과 robots.txt 정리하기
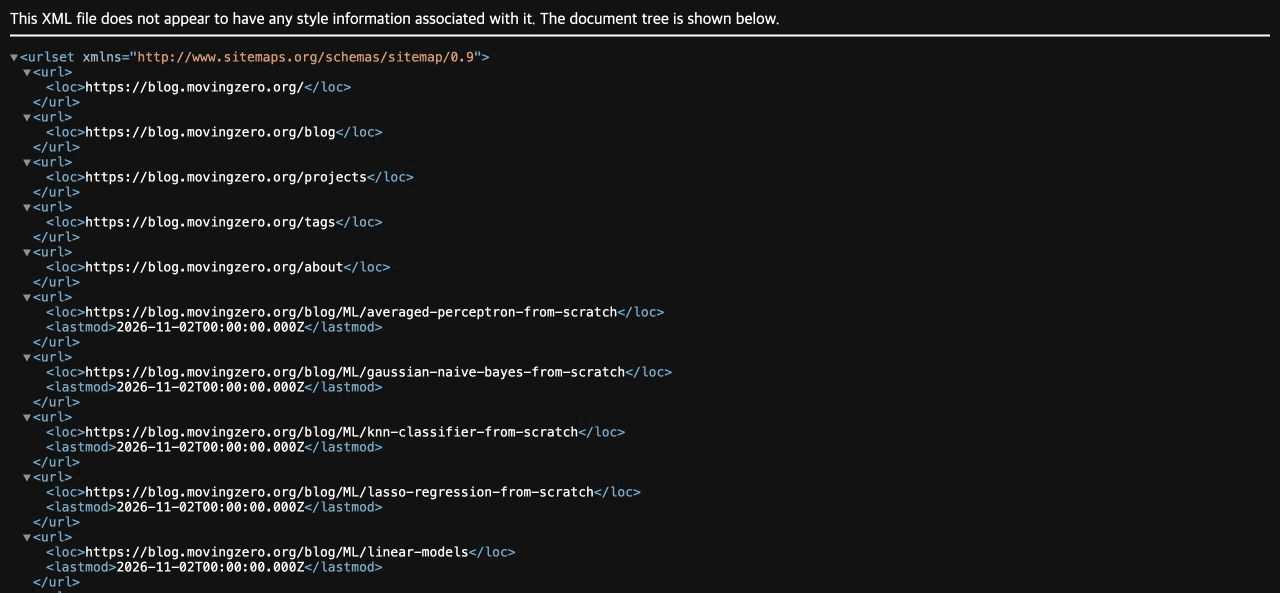
글의 사이트맵 수정일은 lastmod가 있으면 그 값을, 없으면 작성일을 사용한다. 반면 목록 페이지는 실제 콘텐츠 변경 여부와 관계없이 생성 시점을 수정일로 넣고 있었다. 관리하지 않는 수정일은 생략하고, 사이트맵에 소개 페이지인 /about을 추가했다.
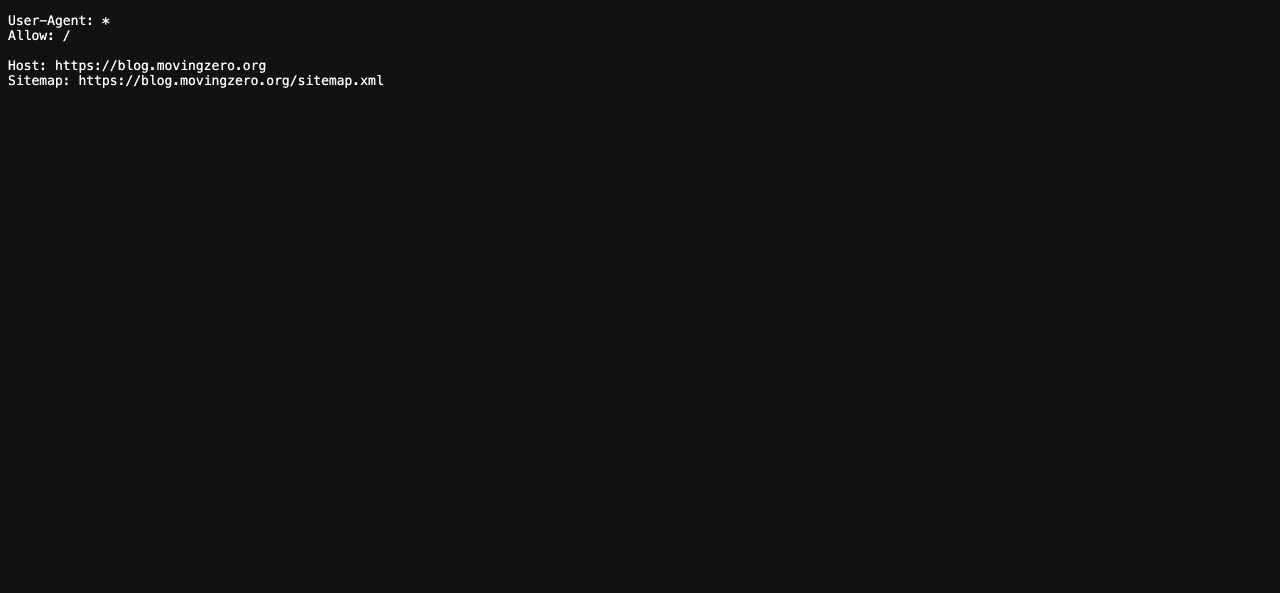
수정 후 robots.txt는 아래와 같이 대표 도메인의 사이트맵을 안내한다.
User-Agent: *
Allow: /

Host: https://blog.movingzero.org
Sitemap: https://blog.movingzero.org/sitemap.xml
여기서 Host 줄이 Google의 대표 URL을 정해주는 것은 아니다. 대표 URL은 canonical, 사이트맵, 리디렉션 등으로 일관되게 전달해야 한다. 또한 robots.txt의 크롤링 허용과 검색 결과의 색인 여부는 서로 다른 문제다.
5. 빌드 결과와 운영 응답 검증하기
로컬에서는 전체 빌드와 ESLint를 실행하고, 생성된 HTML의 canonical과 메타 설명을 확인했다. Vercel 운영 배포 후에는 사이트맵에 포함된 29개 페이지를 다시 요청했다. 이 숫자는 당시 공개 글과 기본 페이지를 합친 값이다.
robots.txt가 대표 도메인의 사이트맵을 안내하는지 확인했다.- 사이트맵 URL에 예전 도메인이나 중복 슬래시가 없는지 확인했다.
- 각 페이지가 정상 응답하고 자신의 주소를 canonical로 지정하는지 확인했다.
- 메타 설명이 있고, 메타 robots와 응답 헤더에
noindex가 없는지 확인했다. - 글 페이지에 JSON-LD가 포함되어 있는지 확인했다.
JSON-LD가 있다는 확인은 Google의 구조화 데이터 적격성 검사와 다르다. 이번 검증만으로 리치 결과 표시나 검색 노출 순위까지 확인한 것은 아니다.
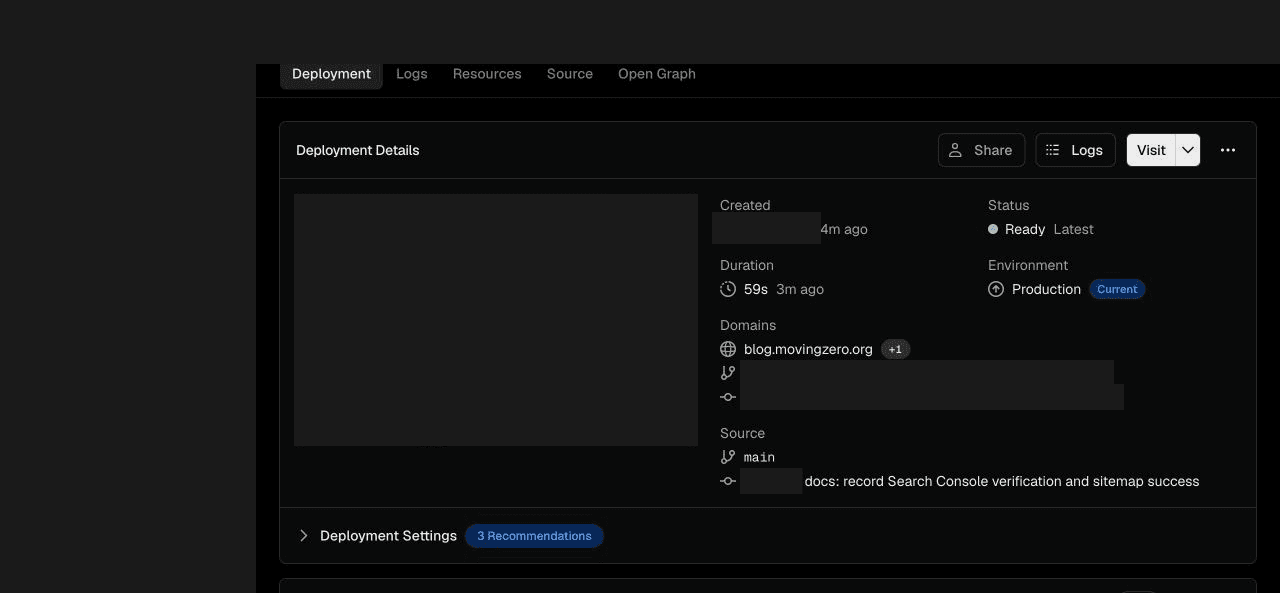
작업 중 로컬 Node.js도 보안 릴리스인 22.23.4로 업데이트했다. .nvmrc와 nvm 기본 버전은 22.23.4로 맞추고, Vercel에는 package.json의 engines.node로 22.x를 지정했다. Vercel의 세부 패치 버전은 플랫폼이 관리하므로 로컬 버전을 올렸다는 사실만으로 운영 런타임의 정확한 패치 버전을 단정하지 않는다.
6. Google Search Console 등록하기
코드에서 사이트맵을 생성하고 배포하는 작업과 Google에 사이트 소유권을 확인하는 작업은 별개다. Search Console에는 대표 주소인 https://blog.movingzero.org/를 URL 접두어 속성으로 추가하고, HTML 파일 방식으로 소유권 확인을 완료했다.
URL 접두어 속성은 지정한 프로토콜과 주소를 기준으로 관리한다. 모든 하위 도메인과 프로토콜을 묶어 관리하는 도메인 속성과는 범위가 다르다. 이번에는 블로그 주소를 대상으로 하고, Vercel에서 인증 파일을 직접 제공할 수 있어 이 방식을 선택했다.
Google이 제공한 인증 HTML 파일을 public/에 추가하고 GitHub에 반영했다. Vercel 자동 배포가 끝난 뒤 운영 도메인에서 파일을 정상적으로 가져올 수 있는지 확인하고, Search Console의 확인 버튼을 눌렀다. 결과 화면에서 확인 방법이 HTML 파일이고 소유권이 확인됐다는 메시지를 확인했다.
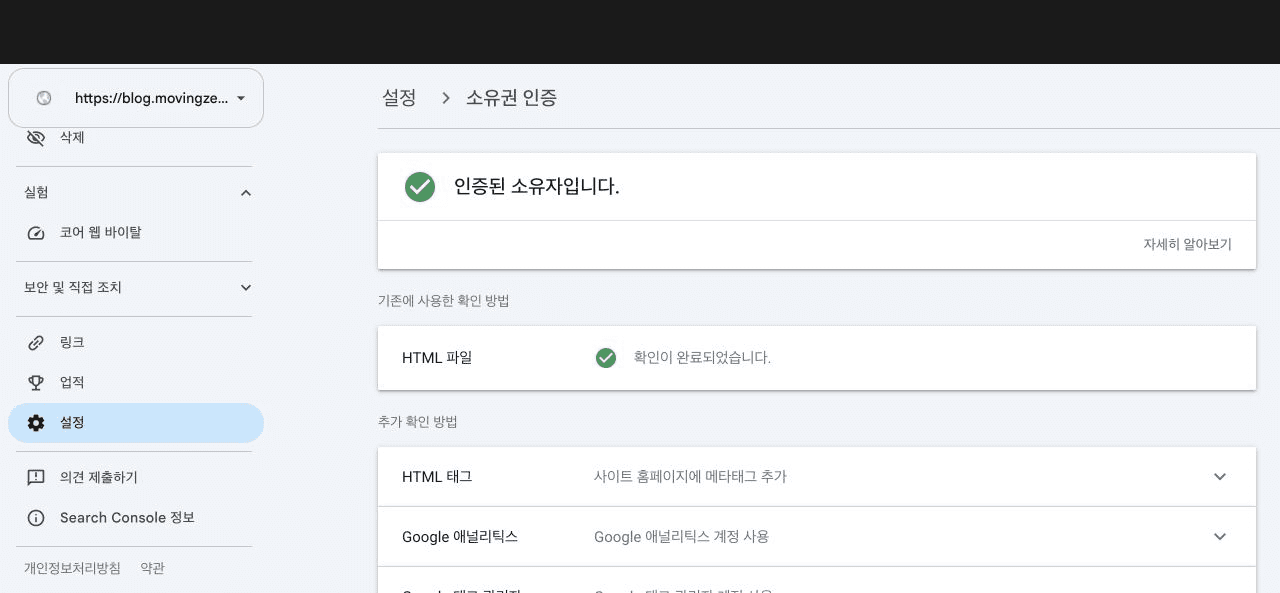
이어서 Sitemaps 메뉴에서 sitemap.xml을 제출했다. 2026년 11월 2일 기준 Search Console에 표시된 결과는 다음과 같다.
| 항목 | 결과 |
|---|---|
| 속성 | https://blog.movingzero.org/ |
| 소유권 확인 방법 | HTML 파일 |
| 제출한 사이트맵 | /sitemap.xml |
| 처리 상태 | 성공 |
| 발견된 페이지 | 29개 |
인증 파일은 확인 후에도 유지해야 한다. Google이 소유권을 다시 확인할 수 있기 때문이다. 인증 파일도 저장소에 포함해 이후 배포에서 빠지지 않도록 했다.
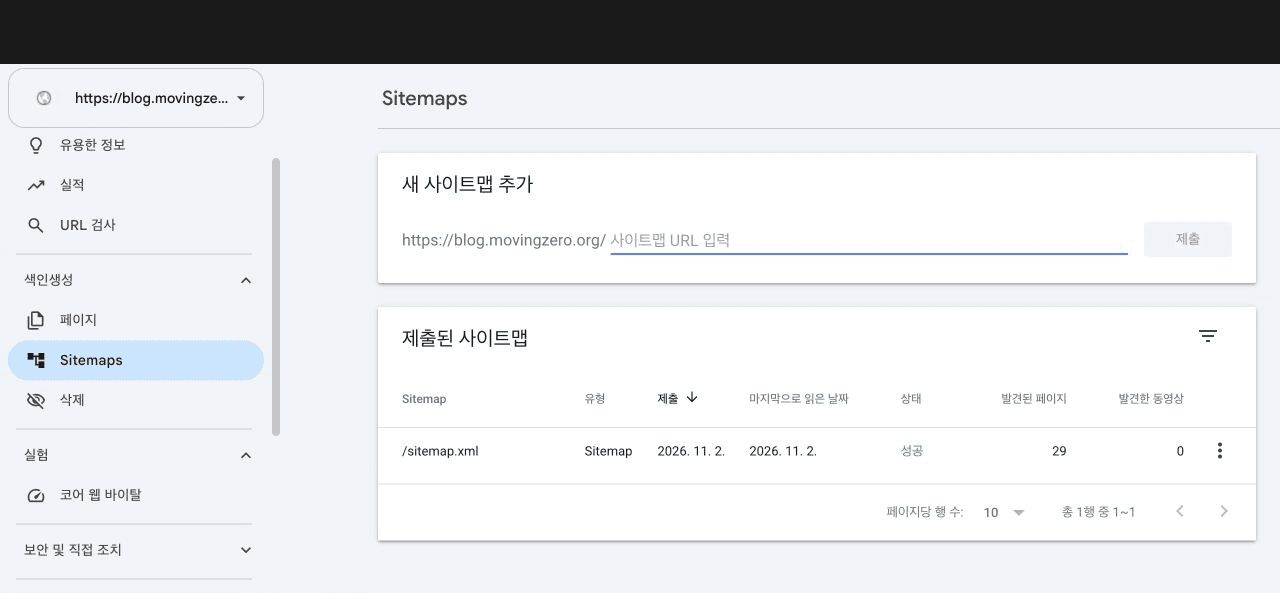
사이트맵 처리 성공과 29개 페이지 발견은 29개 페이지의 색인이 생성됐다는 뜻은 아니다. 사이트맵 제출은 URL 발견을 돕는 절차이며 색인 생성이나 상위 노출을 보장하지 않는다. 등록 직후 실적과 페이지 보고서는 데이터 처리 중으로 표시됐다. 이후에는 페이지 색인 보고서를 확인하고, 실제 검색어별 노출과 클릭이 쌓이면 글의 제목과 내용을 개선할 계획이다.
제목 전체가 아닌 일반 검색어로 테스트하기
2026년 11월 3일에는 site:나 글 제목 전체 대신 독자가 입력할 만한 검색어 6개를 실제 Google에서 검색했다. 첫 페이지의 일반 웹 결과만 확인했으며 AI 개요와 광고는 순위에서 제외했다. 번역 결과에 같은 URL이 중복되는 경우는 한 건으로 계산했다.
| 검색어 | 수정 전 관찰 결과 |
|---|---|
| YARN 스케줄러 차이 | 비교 글이 첫 페이지의 약 5번째 일반 결과에 노출 |
| Capacity Scheduler Fair Scheduler 비교 | 비교 글이 약 2번째 일반 결과에 노출 |
| EMR Livy 세션 생성 실패 | AM 글이 약 8번째에 노출됐으나 Livy 글은 첫 페이지에서 미확인 |
| YARN 큐 메모리 부족 | 첫 페이지에서 블로그 미확인 |
| EMR 큐 설정 | 첫 페이지에서 블로그 미확인 |
| Spark ACCEPTED 대기 | AM 글이 첫 일반 결과에 노출 |
이 결과만으로 사이트 전체가 잘 노출된다거나 노출되지 않는다고 말할 수는 없다. 같은 블로그 안에서도 글과 검색어에 따라 차이가 있었다. 검색량과 경쟁도는 측정하지 않았으며, 위 위치는 특정 시점과 브라우저 환경에서의 관찰값이다. Search Console의 평균 순위와도 다르다.
비교 글은 기존 제목을 유지하고 도입부에 FIFO·Capacity·Fair의 차이를 빠르게 읽을 수 있는 표를 추가했다. 큐 설정 글은 제목과 요약에 EMR 큐 설정 및 ACCEPTED 대기 진단을 드러내고, 자원 할당 대기와 실행 중 메모리 초과 종료를 구분했다. Livy 글은 생성 실패와 starting 대기를 확인할 순서를 도입부에 배치했다. 글의 URL은 유지하고 관련 글 링크의 문구를 수정했다.
이는 검색어를 반복해서 넣기 위한 수정이 아니라, 해당 문제로 들어온 독자가 먼저 필요한 답을 찾도록 내용을 배치한 작업이다. 수정 직후 같은 검색을 반복해 순위 개선 효과를 주장하지는 않는다. Google이 변경 내용을 재수집한 뒤 동일한 검색어로 다시 관찰하고, Search Console에 노출과 클릭 데이터가 쌓이면 페이지별 실적과 함께 비교할 계획이다.
참고자료
https://developers.google.com/search/docs/fundamentals/seo-starter-guide?hl=ko https://searchadvisor.naver.com/guide/seo-help https://developers.google.com/search/docs/fundamentals/how-search-works?hl=ko https://developers.google.com/search/docs/crawling-indexing/robots/intro?hl=ko https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics?hl=ko https://developers.google.com/search/docs/essentials?hl=ko